Mon second cerveau IA existait avant que ça devienne une tendance
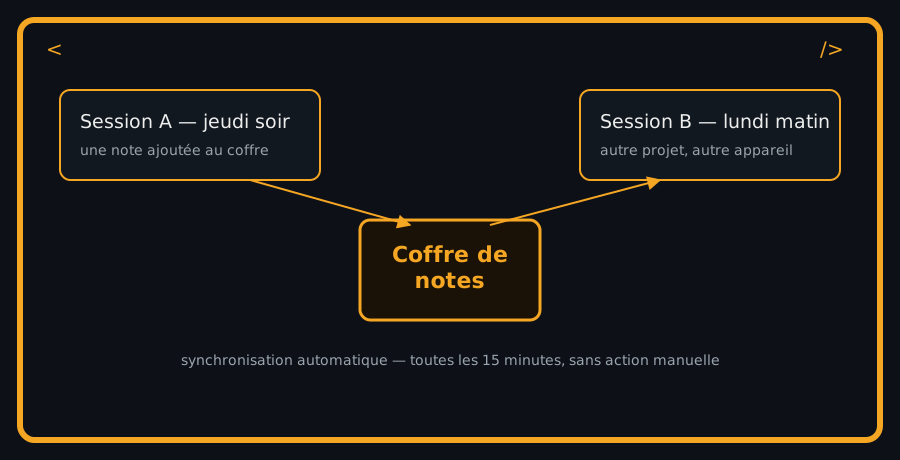
Un jeudi soir, je note dans mon coffre de notes une décision prise sur un projet client. Le lundi suivant, dans une session Claude totalement différente (un autre projet, un autre dossier), cette décision est déjà là, sans que je l’aie recopiée nulle part. Un script tourne en tâche planifiée toutes les 15 minutes et synchronise mes notes entre mes deux ordinateurs via Git. Je n’y pense jamais. Ça fonctionne, point.
Ce n’est pas une astuce que j’ai découverte cette semaine. C’est une structure que j’ai construite petit à petit, bien avant que « donner un second cerveau à son IA » devienne un sujet de newsletter.
Ce qui se passe concrètement
Mon second cerveau tient en trois pièces qui se parlent entre elles :
- Un coffre de notes (Obsidian, gratuit, format texte brut) organisé par grandes zones : méthodes, veille, projets, notes du jour. Et pour répondre à la question évidente : oui, ça marcherait exactement pareil avec de simples fichiers texte, sans Obsidian du tout. Un vault Obsidian n’est rien d’autre qu’un dossier de fichiers
.md. Obsidian n’est qu’une manière agréable de les lire et de les relier entre eux, pas un format propriétaire qui t’enferme. Si le dossier disparaît, les notes restent lisibles dans n’importe quel éditeur de texte. - Une synchronisation automatique entre mes machines, via Git, toutes les 15 minutes, pas besoin d’y penser, pas besoin de cliquer « enregistrer dans le cloud ». Je n’ai même pas configuré ce mécanisme moi-même : j’ai demandé à Claude de le mettre en place, sans avoir besoin de savoir comment faire tourner une tâche planifiée Windows ou écrire le script Git derrière. Je lui ai décrit le résultat voulu (mes notes toujours à jour sur mes deux machines), pas la mécanique.
- Une hiérarchie de fichiers de règles que Claude relit avant d’agir : des règles globales qui s’appliquent partout, puis des règles propres à chaque projet, empilées comme des calques, le même socle à trois étages que je décris en détail dans mon article sur la cascade de fichiers de contexte.
Le résultat : ce que j’écris dans mon coffre de notes un soir devient disponible pour Claude dès la session suivante, peu importe l’appareil, peu importe le projet, sans upload manuel, sans avoir à me souvenir de rejoindre le bon fichier.
Plus élaboré que nécessaire, et je l’assume
Je vais être honnête : ce que je viens de décrire est probablement trop pour quelqu’un qui commence. J’ai ajouté par-dessus une couche de rôles distincts (un qui reformule mes demandes, un autre qui a un droit de veto sur ce qui sort avant que ça m’arrive), utile pour des projets qui s’étalent sur des mois, complètement superflu pour un usage occasionnel.
Le cœur du système, lui, tient en une phrase simple : une base de connaissances qui existe en dehors de la fenêtre de conversation, et qui se remet à jour toute seule. Le reste (Git, les rôles, les personas), ce sont des choix que j’ai faits pour mon volume de travail, pas des prérequis.
Ce que tu peux répliquer sans tout mon attirail
Si tu veux le bénéfice sans la complexité :
- Un coffre de notes en texte brut (Obsidian ou équivalent) : gratuit, pas de compte obligatoire, lisible dans dix ans même si l’outil disparaît.
- Un dossier que ton IA relit systématiquement avant de commencer une tâche. La synchronisation peut être aussi simple qu’un dossier partagé, pas besoin de Git.
- Un répertoire de lancement dédié, pas un dossier fourre-tout. Idéalement, tu ne démarres pas toujours ton IA depuis le même endroit générique (Bureau, Téléchargements) : chaque projet, idée, tâche ou activité a son propre dossier. Le répertoire depuis lequel tu lances fait partie du contexte que ton IA lit : un dossier fourre-tout ne raconte rien, un dossier dédié raconte déjà la moitié de la tâche.
- Une seule règle à respecter : quand tu apprends quelque chose sur ta façon de travailler, ou quand tu corriges une erreur, tu l’écris à cet endroit précis, pas dans ta tête, pas seulement dans la conversation en cours.
Le raté qui vaut la peine d’être mentionné
Ce système n’est pas sans accroc : il m’est déjà arrivé qu’une note modifiée sur un appareil n’ait pas fini de se synchroniser avant que j’ouvre une session sur l’autre. La règle que j’ai adoptée est simple (la version la plus récente gagne), mais ça reste un mécanisme qu’il faut comprendre plutôt que subir. Un second cerveau automatisé, c’est puissant, mais ça reste un système avec ses propres limites, pas une boîte noire infaillible.
En résumé
- Le cœur du système tient en une phrase : une base de connaissances qui existe en dehors de la fenêtre de conversation, et qui se remet à jour toute seule.
- Pas besoin d’Obsidian ni de Git pour commencer : un dossier de fichiers texte que ton IA relit systématiquement suffit.
- Le répertoire depuis lequel tu lances ton IA fait partie du contexte : un dossier dédié par projet vaut mieux qu’un dossier fourre-tout.
- Même la mécanique la plus technique (une synchronisation automatisée) peut être déléguée à l’IA sans avoir à en connaître les rouages.
- Un système automatisé reste un système avec ses limites : comprendre sa règle de conflit vaut mieux que lui faire une confiance aveugle.
Toi, ton IA se souvient-elle de toi d’une session à l’autre, ou tu repars de zéro chaque fois ?
Cet article reprend, en version écrite, ma vidéo « mon second cerveau IA » publiée sur TikTok. Si tu veux la version courte, elle est ici.
Cet article fait partie d’une série sur ma pratique quotidienne de l’IA, après mon atelier IA n’a pas 6 outils, il en a un, vibecoder sans se faire piéger et un Skill Claude, ce n’est pas un prompt sauvegardé. Abonne-toi au blog pour la suite.