Mon atelier IA n’a pas 6 outils, il en a un : moi qui organise
J’ouvre une session Claude Code ce matin, dans le dossier d’un projet que je n’ai pas touché depuis deux semaines. Je n’ai encore rien tapé. Et pourtant, avant même mon premier mot, la session sait déjà : mon rôle, mes règles de travail, l’état du projet la dernière fois que je l’ai quitté, les erreurs que j’ai corrigées la semaine passée et que je ne veux pas répéter.
Rien de magique là-dedans. Juste une pile de fichiers texte que j’ai construite, couche par couche, et qui se relit toute seule à chaque démarrage.
Le réflexe qu’on a tous eu
On a tous commencé pareil : une fenêtre de chat vide, une question tapée à la volée, une réponse générique en retour, et la conclusion rapide que « l’IA n’est pas si utile que ça ». Puis on recommence le lendemain, dans une autre fenêtre vide, en réexpliquant qui on est et ce qu’on veut, comme si la conversation de la veille n’avait jamais existé.
C’est le piège classique : traiter l’IA comme un outil unique et univoque (un chatbot), alors que sa vraie valeur apparaît seulement quand on lui construit un cadre autour. Ce n’est pas la puissance du modèle qui change la donne. C’est ce qu’on lui donne à lire avant de lui parler.
Ce que j’ai fini par construire
Je ne vais pas te vendre une liste universelle de « 6 outils Claude à maîtriser ». Ma pile n’a probablement aucun sens pour ton usage : je fais du développement, de la gestion de contenu et de l’orchestration multi-projets, ce n’est pas ton quotidien. Ce qui compte, c’est le principe, pas ma liste précise. Et le principe tient en deux temps : d’abord un socle qui s’empile tout seul, ensuite des couches qu’on construit par-dessus une fois que ce socle existe.
Précondition à tout le reste : je travaille dans un terminal, pas dans un chat web. Claude Code tourne en ligne de commande, directement dans mes dossiers de projet : il lit et modifie mes vrais fichiers, pas des copier-coller entre deux fenêtres.
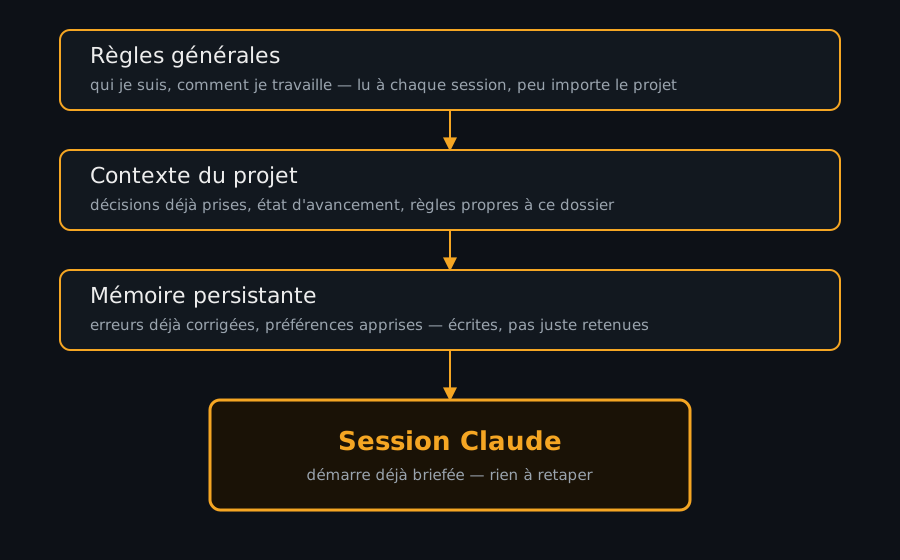
Le socle : trois fichiers qui s’empilent avant que je tape un mot
1. Les règles générales. Le fichier le plus haut de ma pile, ~/.claude/CLAUDE.md, celui que toutes mes sessions lisent en premier peu importe le projet, ne contient que deux lignes :
@CLAUDE.local.md
@NESTOR.md
C’est tout. Pas de règles écrites directement dedans, juste deux renvois vers d’autres fichiers (mes préférences de travail, puis la description de mon système de rôles). Le fichier ne contient rien, il pointe. C’est le même principe qu’un bon index : il te dit où aller chercher, pas la réponse elle-même.
2. Le contexte du projet. Un cran plus bas, chaque projet a son propre CLAUDE.md. Celui de ce blog se décrit lui-même comme « la carte d’entrée du projet » qui « pointe vers les sources de vérité plutôt que de les recopier ». Même logique qu’au niveau général, appliquée à l’échelle d’un seul dossier : décisions déjà prises, état d’avancement, ce qu’il ne faut jamais faire ici (pour ce blog : aucun argument de vente avant 2028).
3. La mémoire qui survit à la session. Ce que j’apprends (une préférence, une erreur à ne pas répéter) est écrit dans une fiche dédiée, pas juste retenu « pour cette conversation ». Chaque fiche suit le même squelette : la règle, puis pourquoi elle existe, puis comment l’appliquer. Exemple réel : une fiche m’apprend que le mot Skill doit rester masculin dans mes articles (« un Skill », jamais « une Skill »), une préférence donnée une fois, il y a plusieurs semaines, jamais eu besoin de la répéter depuis. Voisine de cette mémoire, mais différente : le handoff, une note figée que j’écris pour passer une mission d’une session à l’autre. La distinction tient en une phrase : le handoff est une photo, la mémoire est la source vivante. La photo se relit, mais seule la source se met à jour.
Ce que je construis par-dessus, une fois le socle en place
Trois couches optionnelles, ajoutées seulement quand le socle ne suffit plus :
4. Une couche d’orchestration. Sur mes projets les plus complexes, j’ai des rôles définis : un archiviste, par exemple, dont le seul travail est de classer, versionner et rendre retrouvable chaque livrable, et qui n’intervient qu’après qu’un responsable qualité a validé le résultat. Pas parce que c’est nécessaire pour tout le monde, mais parce que ça m’évite de perdre le fil sur des projets qui s’étalent sur des mois.
5. Des automatismes réutilisables. Des commandes que je déclenche moi-même pour des tâches récurrentes. /today, par exemple : une commande en lecture seule qui relit l’état de tous mes projets actifs et me propose un ordre de priorité : ce qui est bloqué d’abord, puis les échéances proches, puis ce qui stagne, plutôt que de rouvrir chaque dossier un par un pour retrouver où j’en étais.
6. Des agents en délégation. Sur une tâche qui demande d’explorer plusieurs pistes en parallèle, je peux envoyer plusieurs instances travailler en même temps plutôt que de tout faire en série dans un seul fil. Exemple tout frais : pour écrire les exemples de cet article, j’ai envoyé deux instances explorer mon propre système en parallèle : l’une la cascade de fichiers CLAUDE.md, l’autre mes commandes et ma mémoire, pendant que je formulais mes retours. Les deux ont fini avant que j’aie terminé de relire mes propres notes.
Six briques, oui, mais organisées en deux temps, pas à plat. Elles ne servent à rien si tu ne les organises pas toi-même autour de ta façon de travailler.
Le raté qui m’a servi de leçon
Cette structure n’est pas tombée du ciel et elle n’est pas infaillible. Début juillet, j’ai publié un article de blog en laissant une affirmation non sourcée dedans. Ma propre règle (« toujours vérifier avant d’avancer un chiffre ») existait déjà quelque part dans mes fichiers, mais je ne l’avais pas appliquée à cette tâche précise. La mémoire ne sert à rien si on ne se relit pas soi-même de temps en temps pour vérifier qu’elle est encore suivie. J’ai corrigé, documenté la leçon dans mes fichiers de contexte, et la prochaine session en tiendra compte automatiquement. C’est exactement le point : le système n’est pas parfait, il s’améliore à chaque raté documenté, à condition qu’on prenne deux minutes pour l’écrire.
Ce que tu peux en retenir sans copier ma stack
Tu n’as pas besoin d’un système d’orchestration à plusieurs rôles ni d’une mémoire aussi élaborée que la mienne pour commencer. Trois principes suffisent, peu importe l’outil d’IA que tu utilises :
- Un fichier de contexte permanent, même minimal : qui tu es, comment tu aimes qu’on te réponde, ce que le projet en cours doit accomplir. Cinq minutes à écrire, relu automatiquement à chaque session si l’outil le permet.
- Au moins un automatisme sauvegardé pour une tâche que tu refais chaque semaine (un gabarit, une commande, une checklist) plutôt que de la reformuler de zéro à chaque fois.
- Un endroit où noter ce que tu apprends sur ta propre façon de travailler avec l’IA, pour ne pas répéter la même erreur dans trois semaines parce que tu l’auras oubliée.
Pas besoin de six outils. Juste besoin de décider, une bonne fois, comment tu veux que l’IA te retrouve la prochaine fois que tu ouvres une session, plutôt que de recommencer à zéro à chaque fois. C’est tout ce que ma pile fait, au fond : elle sait déjà, avant que je tape un mot, parce que j’ai pris le temps de le lui écrire une fois.
En résumé
- Une session Claude qui « sait déjà » qui je suis n’a rien de magique : c’est une pile de fichiers texte relue automatiquement à chaque démarrage.
- Le socle tient en trois étages : règles générales (
~/.claude/CLAUDE.md, deux lignes qui ne font que pointer ailleurs), contexte du projet, mémoire persistante. - Par-dessus, trois couches optionnelles seulement quand le besoin s’en fait sentir : orchestration, automatismes réutilisables, délégation à des agents en parallèle.
- Le système n’est pas infaillible : il s’améliore à chaque raté documenté, pas avant.
- Pour démarrer : un fichier de contexte minimal, un automatisme sauvegardé, un endroit où noter ce que tu apprends. Rien de plus n’est nécessaire au départ.
Toi, tu as un fichier qui dit à ton IA qui tu es, ou tu repars de zéro à chaque conversation ? Dis-le-moi en commentaire.
Cet article reprend, en version écrite, ma vidéo « l’atelier IA » publiée sur TikTok. Si tu veux la version courte, elle est ici.
Si l’incident de sécurité que j’évoque plus haut t’intéresse, j’en ai fait un article complet : la leçon de sécurité que le vibecoding m’a apprise à mes dépens.
Ce billet ouvre une série sur ce que je retiens de ma pratique quotidienne de l’IA. Abonne-toi au blog pour ne pas manquer la suite.