Installer claude-mem : la mémoire qui survit à la fermeture du terminal
En une quinzaine de minutes, tu vas installer une mémoire persistante, la faire écrire en français, et décider explicitement ce qu’elle n’a pas le droit de retenir. À la session suivante, Claude Code démarre en sachant déjà sur quoi tu travaillais.
Jusqu’ici, cette série t’a fait écrire du contexte à la main : le CLAUDE.md générique, celui du projet, puis des Skills. Tous ces fichiers ont un point commun : c’est toi qui les tiens à jour. Ce que le CLAUDE.md ne dit pas, c’est ce qui s’est passé hier soir dans ta session : quelle piste tu as abandonnée, pourquoi tu as renoncé à cette bibliothèque, quel bogue tu venais tout juste de comprendre. Ça, ça meurt à la fermeture du terminal, et tu le réexpliques le lendemain. C’est ce trou-là que claude-mem bouche, et il ouvre le bloc Mémoire de cette série.
Ce qu’il te faut
Claude Code installé, et Node.js en version 20 ou plus (node --version pour vérifier). Le reste s’installe tout seul : claude-mem télécharge au besoin deux programmes annexes dont il a besoin pour tourner, Bun et le gestionnaire Python uv. Prévois un redémarrage de Claude Code à la fin.
Étape 1 — Installer le plugin (3 minutes)
Depuis Claude Code, deux commandes. La première indique où trouver le dépôt qui contient l’extension (plugin, un module complémentaire qui ajoute une fonction à Claude Code), la seconde l’installe :
/plugin marketplace add thedotmack/claude-mem
/plugin install claude-mem
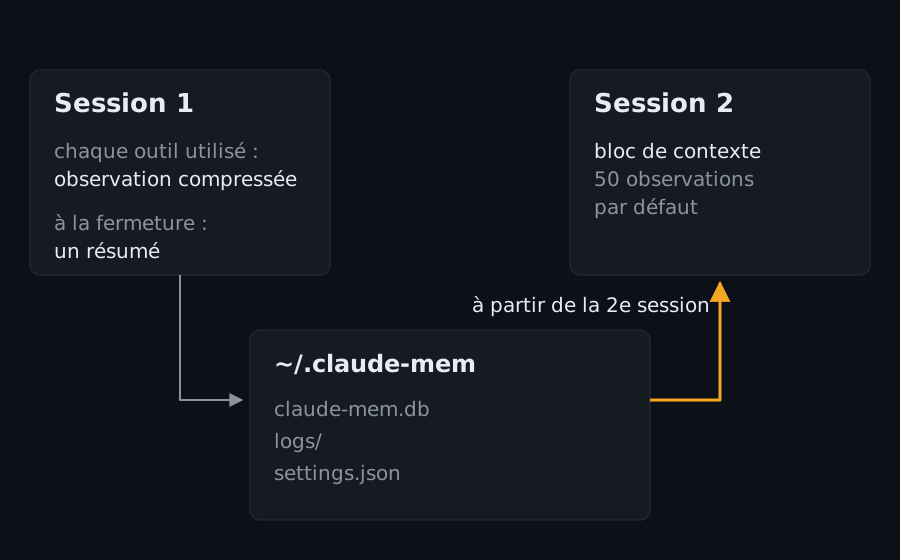
Puis quitte Claude Code et relance-le. Le plugin s’accroche au cycle de vie de tes sessions par des points d’accroche (hooks, on y reviendra dans le bloc dédié de cette série) : à chaque outil utilisé, il fabrique une observation compressée ; à la fin de la session, il en tire un résumé.
Si tu préfères la ligne de commande, npx claude-mem install fait le même travail hors de Claude Code, ce qui est pratique dans un script d’installation de poste. Une seule voie est à éviter : npm install -g claude-mem installe la bibliothèque seule, sans brancher les hooks ni le service local. Tu croirais avoir installé la mémoire, elle ne capterait rien.
Étape 2 — Vérifier que la mémoire capte vraiment (2 minutes)
Le piège de cette étape : l’injection de contexte ne commence qu’à ta deuxième session dans un projet donné. La première ne fait qu’amorcer la mémoire. Beaucoup d’installations sont déclarées ratées à ce moment précis, alors qu’elles fonctionnent.
Travaille normalement dix minutes dans un projet, ferme Claude Code, relance-le au même endroit. En haut de la nouvelle session, un bloc de contexte récapitule ce qui s’est passé la fois d’avant. Si rien n’apparaît, vérifie d’abord que les données existent :
ls ~/.claude-memGet-ChildItem $HOME.claude-memTu dois y voir un fichier claude-mem.db, un dossier logs/ et un settings.json. Une base présente mais aucune injection au démarrage veut dire que le plugin capte mais que la session n’a pas été refermée proprement : les résumés se fabriquent à la fermeture, pas en continu.
Étape 3 — Faire écrire la mémoire en français (2 minutes)
Par défaut, les observations sont rédigées en anglais, même si toute ta session s’est déroulée en français. Ce n’est pas cosmétique : ces textes seront relus par toi et cherchés par toi, dans six mois, avec les mots que tu emploies naturellement. Une mémoire en anglais d’un travail en français se cherche mal.
Le mode se change dans ~/.claude-mem/settings.json. Ouvre le fichier et remplace la valeur de CLAUDE_MEM_MODE :
{
  "CLAUDE_MEM_MODE": "code--fr"
}
Ne recopie pas ce bloc par-dessus le fichier entier : il contient déjà des dizaines de réglages, tu ne modifies que cette ligne. Le catalogue complet des modes disponibles se liste ainsi :
ls ~/.claude/plugins/marketplaces/thedotmack/plugin/modes/Get-ChildItem $HOME.claudepluginsmarketplacesthedotmackpluginmodesUne trentaine de langues y figurent, plus quelques modes de travail non linguistiques (code--chill pour un ton moins verbeux, par exemple). Redémarre Claude Code pour appliquer le changement. Attention : les observations déjà enregistrées restent dans leur langue d’origine, seules les nouvelles suivent le mode.
Étape 4 — Décider ce qui ne doit jamais être retenu (4 minutes)
C’est l’étape que la plupart des tutoriels sautent, et c’est la seule dont l’oubli se paie. Tu viens de brancher un outil qui archive automatiquement tout ce que tu fais dans ton terminal. Deux réglages valent la peine d’être posés le jour de l’installation plutôt qu’après un incident.
Un, le tri à la source. La clé CLAUDE_MEM_SKIP_TOOLS du même settings.json liste les outils dont l’usage n’est pas transformé en observation. La valeur par défaut y met déjà les outils de simple lecture, qui produiraient surtout du bruit. Si tu travailles sur un dépôt qui contient des données clients, c’est ici que tu réduis la surface.
Deux, l’exclusion ponctuelle. Quand tu colles dans une conversation quelque chose qui ne doit pas être archivé (un extrait de courriel, une clé, un nom de client), encadre-le de balises <private> : le contenu ainsi marqué est exclu du stockage.
Il reste un point à comprendre honnêtement, parce qu’il compte au Québec comme ailleurs : la base de données, l’index qui range les textes par proximité de sens (l’index vectoriel) et les journaux vivent entièrement sur ta machine, dans ~/.claude-mem. Mais résumer les observations, ça, c’est fait par un modèle d’IA. Avec la configuration par défaut, c’est ton abonnement Claude qui s’en charge. Autrement dit, le contenu de tes sessions passe par le même fournisseur que tes conversations habituelles, ni plus ni moins. Ce n’est pas un outil qui reste local de bout en bout, et ça vaut la peine de le savoir avant de le brancher sur un dépôt sensible.
Et quand la mémoire devient grosse ?
La question tombe toujours au bout de quelques semaines, et elle repose sur une inquiétude mal placée. Ma base personnelle, le fichier claude-mem.db, pèse 37,8 Mo après trois mois d’usage quotidien ; avec l’index vectoriel, les journaux et les sauvegardes, le dossier ~/.claude-mem complet dépasse les 300 Mo. Sur un disque de 2026, dans les deux cas, c’est un non-sujet. Ce qui coûte vraiment, c’est le bloc de contexte réinjecté au démarrage de chaque session, qui se paie en jetons (tokens, l’unité qui mesure la quantité de texte que Claude doit lire) à chaque fois.
Le robinet est donc du côté de l’injection, pas du stockage. Dans settings.json, CLAUDE_MEM_CONTEXT_OBSERVATIONS fixe le nombre d’observations remontées au démarrage (50 par défaut). Si ton bloc de contexte s’étire sur un écran entier, descends-le à 20 ou 30 avant toute autre manœuvre. Le réglage se change aussi depuis l’interface web du service local, sans toucher au fichier.
Second levier, plus tranchant : CLAUDE_MEM_EXCLUDED_PROJECTS liste les dossiers que la mémoire ignore complètement, en écriture comme en lecture. C’est le bon endroit pour un dépôt qui pollue plus qu’il n’aide, ou pour un client dont tu ne veux aucune trace.
Ce qui n’existe pas, en revanche, c’est une commande qui purgerait les observations de plus de six mois. Et attention à un contresens répandu : npx claude-mem uninstall retire le plugin, ses points d’accroche et son enregistrement dans Claude Code, mais conserve ton dossier ~/.claude-mem. Il te le dit d’ailleurs en fin de course, et te laisse l’effacement à la main : rm -rf ~/.claude-mem, ou Remove-Item -Recurse $HOME.claude-mem sous PowerShell. Sauvegarde claude-mem.db avant si tu tiens à l’historique, et garde ça pour un vrai dernier recours : une mémoire ancienne ne ralentit rien, elle occupe seulement du disque.
Le réflexe qui change tout après une semaine
Résiste à l’envie de tout mémoriser dès le premier jour. Le plugin propose une commande pour ingérer un dépôt entier d’un coup, et c’est tentant. Laisse plutôt la mémoire se remplir toute seule pendant une semaine de travail réel : ce qui s’y dépose est alors le reflet de ce que tu fais vraiment, pas un inventaire de ton code. Une mémoire de quinze sessions vécues sert mieux qu’un instantané exhaustif d’un dépôt que tu connais déjà.
Ce qui vient de se passer
Tu as ajouté à Claude Code une couche que ni le CLAUDE.md ni les Skills ne couvraient : la trace de ce qui s’est passé, pas seulement l’énoncé de ce qui doit se passer. Les trois fichiers deviennent complémentaires. Le CLAUDE.md dit les règles, le Skill dit la procédure, la mémoire dit l’historique.
En résumé
/plugin marketplace add thedotmack/claude-mempuis/plugin install claude-mem, et redémarre. Jamaisnpm install -g claude-mem: ça installe la bibliothèque sans brancher les hooks.- L’injection de contexte démarre à la deuxième session d’un projet, pas à la première. Une première session sans contexte n’est pas une panne.
CLAUDE_MEM_MODE: "code--fr"dans~/.claude-mem/settings.jsonfait écrire les observations en français, ce qui les rend cherchables avec tes propres mots.- Pose tes limites le jour de l’installation :
CLAUDE_MEM_SKIP_TOOLSpour le tri permanent, balises<private>pour l’exclusion ponctuelle. - Les données restent sur ta machine, mais la compression passe par ton fournisseur de modèle. À savoir avant de brancher ça sur un dépôt sensible.
- Une base volumineuse n’est pas un problème (37,8 Mo de base, un peu plus de 300 Mo de dossier complet après trois mois). Si le contexte de démarrage devient lourd, baisse
CLAUDE_MEM_CONTEXT_OBSERVATIONS; pour couper un projet entier,CLAUDE_MEM_EXCLUDED_PROJECTS. Aucune purge par ancienneté n’existe. - Désinstaller n’efface pas :
npx claude-mem uninstalllaisse~/.claude-memen place, l’effacement des données est un geste manuel séparé. - Laisse la mémoire se remplir une semaine avant de juger : quinze sessions réelles valent mieux qu’une ingestion massive du dépôt.
Prochaine étape : interroger cette mémoire en langage naturel avec mem-search, pour retrouver une décision prise il y a trois semaines sans rouvrir une seule session.
Cette mise en pratique poursuit la série sur l’installation et la configuration de Claude Code, de zéro jusqu’à un premier programme fonctionnel. La vidéo est ici.
Abonne-toi au blog pour suivre la suite de la série.