Retrouver une décision prise il y a trois semaines, sans rouvrir une seule session
En une dizaine de minutes, tu vas apprendre à interroger la mémoire que tu as installée à l’article précédent : poser une question sur ton propre passé, remonter le fil autour d’un résultat, et cadrer la recherche quand elle ramène trop de bruit.
Tu as installé claude-mem, tu as travaillé une ou deux semaines, la base s’est remplie. Sauf qu’une mémoire qui se remplit sans qu’on sache la fouiller, c’est un grenier. La question qui revient dans la vraie vie n’est jamais « montre-moi mes observations » : c’est « on avait réglé ça comment, la dernière fois ? », ou pire, « pourquoi diable j’ai choisi cette bibliothèque plutôt que l’autre ? ». Le Skill mem-search, installé en même temps que l’extension (plugin) claude-mem, existe exactement pour ça.
Ce qu’il te faut
claude-mem installé et actif depuis au moins quelques sessions réelles. Ne fais pas ce hands-on sur une mémoire vide : tu chercherais dans le néant et tu conclurais que l’outil ne marche pas. Une semaine d’usage suffit largement.
Étape 1 — Poser la question comme une question, pas comme une commande (3 minutes)
Premier réflexe à désapprendre : tu n’as aucune commande à taper. mem-search est un Skill, il se déclenche tout seul quand ta formulation ressemble à une question sur le passé. Dans une session ordinaire, écris simplement :
On avait réglé le problème d'authentification comment, le mois dernier ?Claude va chercher dans la base et te répond avec les enregistrements qui collent. Ce qui fait la différence entre un déclenchement et un silence, c’est un détail de formulation : la description du Skill vise les questions qui portent sur des sessions précédentes. Compare ces deux phrases :
- « comment on gère l’authentification ? » : question au présent, Claude répond de tête ou lit ton code, la mémoire ne bouge pas ;
- « comment on avait géré l’authentification ? » : question au passé, le Skill se déclenche.
C’est le même mécanisme que celui vu à l’article sur la description d’un Skill, observé cette fois de l’autre côté : tu es l’utilisateur, et c’est ta formulation qui doit tomber dans la cible. Les trois tournures qui marchent à tout coup : « on avait fait ça comment », « pourquoi j’ai choisi », « qu’est-ce qui s’est passé la semaine du ». Si rien ne se déclenche, tu peux forcer la main en nommant l’outil : « cherche dans la mémoire ce qu’on a fait sur l’authentification ».
Ce que tu récupères ressemble à ça, une ligne par enregistrement :
| ID     | Time    | T | Title                                    | Read |
|--------|---------|---|------------------------------------------|------|
| #6359  | 9:31 PM | ✓ | Ajout du refus des tirets cadratins      | ~167 |
| #6361  | 9:31 PM | ✓ | Règle reportée dans l'index de mémoire   | ~122 |
Un identifiant, une heure, un type, un titre. Et une dernière colonne qui intrigue au premier regard : le coût en jetons (tokens, l’unité qui sert à mesurer la quantité de texte que Claude doit lire) de l’enregistrement complet, si tu décides de l’ouvrir. On y revient plus bas, parce que c’est toute la logique de l’outil.
Étape 2 — Remonter le fil autour d’un résultat (3 minutes)
Un titre te dit qu’une décision a été prise. Il ne te dit pas pourquoi, ni ce qui l’entourait. C’est là que la plupart des gens abandonnent et rouvrent le dossier à la main.
Prends l’identifiant qui t’intéresse et demande le contexte autour :
Montre-moi ce qui s'est passé autour de #6359.Tu ne récupères pas un enregistrement, tu récupères une séquence : les deux ou trois moments qui précèdent, le point d’ancrage, les deux ou trois qui suivent, groupés par fichier touché. En pratique, ça reconstitue le raisonnement :
brand-voice.md
| #6358 | ○ | Repérage des règles de style existantes    |
| #6359 | ✓ | Ajout du refus des tirets cadratins  <- ANCHOR |
memory/MEMORY.md
| #6361 | ✓ | Règle reportée dans l'index de mémoire      |
Trois lignes, et la décision redevient lisible : d’abord un repérage, ensuite la règle écrite au bon endroit, enfin sa propagation ailleurs. Voilà ce que ta mémoire de cerveau humain avait perdu, et que le fichier seul ne raconte pas. Tu peux régler la profondeur dans les deux sens : « remonte dix enregistrements avant et dix après », ou au contraire « juste deux de chaque côté ».
Étape 3 — Cadrer la recherche quand ça ramène trop de bruit (2 minutes)
Au bout de deux mois, une recherche large ramène trente résultats et tu n’es pas plus avancé. Quatre filtres suffisent à retomber sur tes pieds, et tu les demandes en français, sans syntaxe à retenir :
- par projet : « cherche seulement dans le projet facturation » ;
- par type : « seulement les corrections de bogues » (les types produits : correction (bugfix), fonctionnalité (feature), réusinage (refactor), décision, découverte, changement) ;
- par date : « seulement depuis le 1er août » ;
- par ordre : « les plus récents d’abord » ou « par pertinence ».
Le filtre par type est le plus sous-estimé. « Pourquoi j’ai choisi X » se cherche en filtrant sur les décisions, et une base de deux mille enregistrements en contient rarement plus de quelques dizaines. Tu passes de trente résultats flous à trois résultats justes.
Étape 4 — Chercher depuis le terminal, hors de Claude Code (2 minutes)
Il y a une voie en ligne de commande, pratique quand tu veux juste vérifier un truc sans ouvrir de session :
npx claude-mem search "authentification"La commande est identique sous PowerShell et sous bash, c’est le même appel npx. Attention au piège, je suis tombé dedans en préparant cet article : si le service local ne tourne pas, la commande ne cherche rien et se contente de répondre Worker is not running. Elle te donne alors le remède :
npx claude-mem startEt prépare-toi au format : cette voie n’utilise pas le Skill, elle te rend la réponse brute du service en JSON, tableau markdown échappé compris. C’est fait pour être relu vite ou tuyauté ailleurs, pas pour être joli.
Quand la recherche ne trouve rien alors que tu es sûr
Trois causes, dans l’ordre de fréquence.
La langue. C’est la plus vicieuse. Si tu n’as pas basculé la mémoire en français à l’installation, tes observations sont rédigées en anglais pendant que tu les cherches avec tes mots à toi. Tu cherches « facturation », la base contient invoicing, et tu ne trouves rien alors que tout est là. Le réglage CLAUDE_MEM_MODE vu à l’article précédent règle le problème pour la suite, mais pas rétroactivement : les anciens enregistrements restent dans leur langue d’origine. En attendant, cherche en anglais ce qui a été écrit en anglais.
Le projet. La mémoire est cloisonnée par dossier de travail. Si tu poses la question depuis un autre répertoire que celui où le travail a eu lieu, tu interroges la mémoire d’un autre projet : la base est unique, mais elle se filtre par dossier de travail, et le filtre suit ton répertoire courant. Nomme le projet dans ta question, ou repositionne-toi au bon endroit.
Le vocabulaire. Une observation est un résumé écrit par un modèle, pas ta phrase d’origine. Le mot exact que tu avais tapé n’y figure pas forcément. Cherche le concept, pas la formule : « lenteur au démarrage » plutôt que le nom de la fonction que tu avais optimisée.
Pourquoi Claude ne rapatrie jamais tout d’un coup
Tu as peut-être remarqué que rien, dans les étapes précédentes, ne t’a donné le texte complet des enregistrements. C’est délibéré, et c’est le seul point de mécanique qui vaut la peine d’être compris.
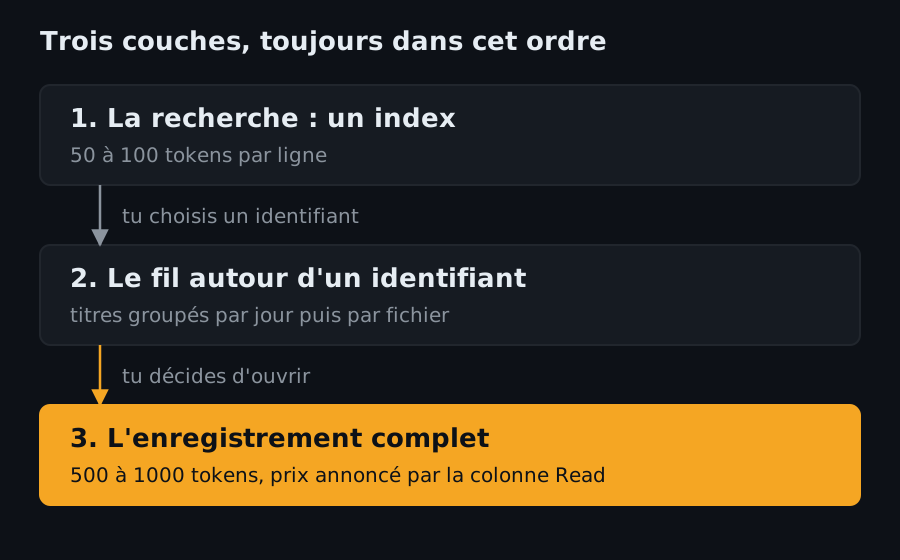
L’outil travaille en trois couches, toujours dans le même ordre. La recherche te rend un index, environ 50 à 100 tokens par ligne. Le fil te rend une séquence de titres groupés par jour puis par fichier, à peine plus cher. L’ouverture d’un enregistrement complet, elle, se compte en centaines de tokens : les auteurs annoncent 500 à 1000 pièce, et la colonne Read te donne le chiffre exact du tien avant que tu paies. Filtrer avant d’ouvrir, plutôt qu’ouvrir vingt résultats pour en garder deux, c’est le rapport de dix annoncé par les auteurs du Skill.
Concrètement, ça veut dire que tu peux fouiller trois mois d’historique en dépensant l’équivalent d’un fichier moyen. La mémoire ne mange ton contexte que si tu lui demandes d’ouvrir en grand, et cette décision reste la tienne.
Dernier détail utile : si tu préfères une réponse rédigée à des enregistrements bruts, le Skill knowledge-agent regroupe d’abord un ensemble filtré de textes tirés de ton historique (un corpus), le charge en session, puis répond en prose. Plus lourd à démarrer, mais parfois exactement ce qu’il te faut.
Le test qui prouve que tu as compris
Choisis une décision technique que tu as prise il y a au moins deux semaines et dont tu ne te rappelles plus la raison. Cherche-la, ouvre le fil autour, puis relis. Si tu ressors avec le pourquoi et pas seulement le quoi, la mémoire est devenue un outil de travail. Sinon, ta base est probablement trop jeune : laisse-la vivre encore une semaine.
En résumé
mem-searchne se tape pas, il se déclenche : formule au passé (« on avait fait ça comment »), pas au présent.- La recherche rend un index de titres, pas des textes complets. C’est normal et c’est le but.
- Un titre dit le quoi, le fil autour d’un identifiant dit le pourquoi. C’est la fonction la plus utile de l’outil, et la moins connue.
- Quatre filtres suffisent, demandés en français : projet, type, date, ordre. Le filtre sur les décisions est le meilleur raccourci pour retrouver un choix ancien.
- En terminal,
npx claude-mem search "…"fonctionne, à condition que le service tourne (npx claude-mem start). - Trois couches : quelques dizaines de tokens par ligne d’index contre des centaines par enregistrement complet. Fouiller coûte peu, tout ouvrir coûte cher, et la colonne
Readt’annonce le prix avant l’achat.
Prochaine étape : se passer d’outil externe, et voir ce qu’une simple arborescence de dossiers bien tenue apporte déjà comme mémoire.
Cette mise en pratique poursuit la série sur l’installation et la configuration de Claude Code, de zéro jusqu’à un premier programme fonctionnel. La vidéo est ici.
Abonne-toi au blog pour suivre la suite de la série.