Ta mémoire tient dans trois fichiers, pas dans un outil de plus
En un quart d’heure, tu vas créer une arborescence de trois fichiers qui capture tes décisions de projet et se relie à Claude Code sans plugin, sans base de données, sans rien à installer.
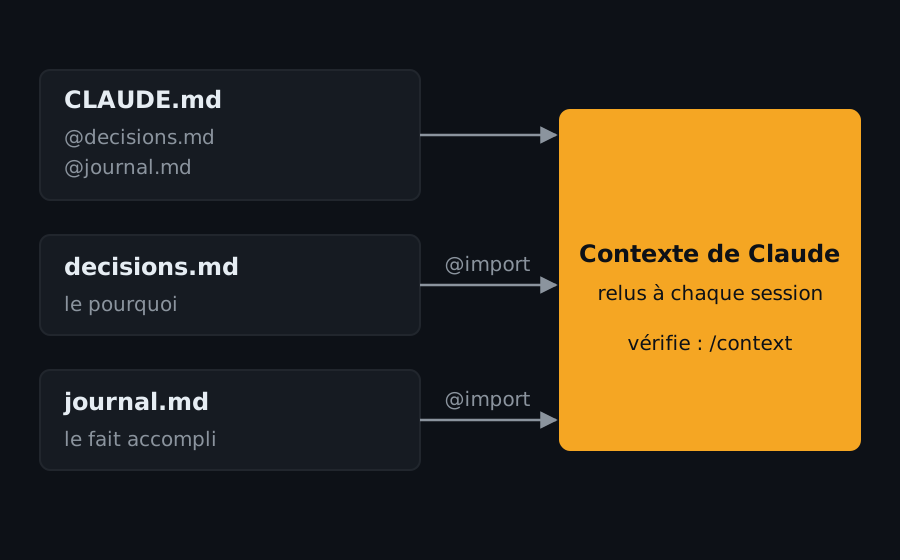
Tu as installé claude-mem et appris à l’interroger. Bonne nouvelle pour la suite : si tu n’as pas envie d’installer quoi que ce soit, ou si tu veux juste comprendre ce que la mémoire automatique fait en plus d’un fichier bien tenu, ce hands-on marche sans aucun outil externe. Trois fichiers texte, une convention d’écriture, et le mécanisme @import déjà vu à l’article sur le CLAUDE.md de sous-projet suffisent à donner à Claude un vrai fil de tes décisions.
Ce qu’il te faut
Un projet avec un CLAUDE.md à la racine (vu à cet article). Rien d’autre. Pas besoin que claude-mem soit installé, désinstallé, ou même connu.
Étape 1 — Comprendre ce qu’un fichier texte fait déjà (2 minutes)
Un CLAUDE.md seul répond à une question : « comment ce projet fonctionne-t-il, en général ? ». Il ne répond pas à une deuxième question, tout aussi fréquente : « pourquoi on a choisi ça, et pas autre chose, le 12 du mois dernier ? ». C’est cette deuxième question qui pousse les gens vers une mémoire automatique. Sauf qu’un fichier texte, relu par Claude à chaque session grâce à @import, répond déjà à 80 % des cas où tu cherches une décision précise et récente. Ce qu’il ne fait pas : retrouver une idée à partir de son sens plutôt que de ses mots exacts (ce qu’on appelle la recherche sémantique), classer tout seul par type, ou reconstituer automatiquement le fil des événements autour d’une date. C’est le compromis de cet article, pas un défaut caché.
Étape 2 — Créer le fichier decisions.md (3 minutes)
À la racine du projet, crée un fichier decisions.md. Une ligne par décision, format fixe :
# Décisions du projet

## 2026-08-23 — Pagination côté serveur plutôt que côté client
Le tableau dépasse 5000 lignes en prod. Charger tout côté client
faisait planter le navigateur sur les gros comptes. Pagination
par lots de 100, filtrage renvoyé au serveur.

## 2026-08-15 — Abandon de la librairie de dates X
Bug récurrent sur les fuseaux horaires côté Québec/France, non
corrigé depuis 8 mois sur le dépôt amont. Remplacée par Y.
Trois éléments obligatoires par entrée : la date, la décision en titre, le pourquoi en une ou deux phrases. Le pourquoi est la seule partie qui compte vraiment : le code te dit déjà quoi a été fait, seul ce fichier te dit pourquoi. Une entrée sans « pourquoi » est une ligne perdue, autant ne pas l’écrire.
Étape 3 — Relier le fichier à Claude Code (2 minutes)
Ouvre ton CLAUDE.md de projet et ajoute une ligne :
@decisions.mdC’est tout. Au prochain lancement de session, Claude charge le contenu de decisions.md en même temps que le reste du CLAUDE.md. C’est le même principe que l’article sur le CLAUDE.md de sous-projet, sauf qu’ici tu ajoutes une liste de décisions plutôt qu’un autre CLAUDE.md. Vérifie que ça marche avec /context, la commande qui affiche tout ce que Claude a en mémoire pour la session en cours (la fenêtre de contexte, ou context window) : le contenu de decisions.md doit y apparaître.
Étape 4 — Ajouter un deuxième fichier pour ce qui est fait, pas décidé (3 minutes)
decisions.md répond à « pourquoi ». Un deuxième fichier, journal.md, répond à « qu’est-ce qui a été fait, et quand ». La distinction compte : une décision est un choix qui engage la suite (« on migre vers Y »), une entrée de journal est un fait accompli (« migration terminée, 3 fichiers restants en Y-legacy »). Mélanger les deux dans un seul fichier le rend illisible en six mois : tu ne sauras plus si une ligne est encore d’actualité ou déjà classée.
# Journal

## 2026-08-23
Migration vers Y : 12/15 fichiers convertis. Reste : facturation.py,
export_pdf.py, tests_legacy.py (bloqués par une dépendance non
encore portée).
Importe-le de la même façon, en ajoutant @journal.md sous la ligne précédente dans le CLAUDE.md.
Ce que ça change, sur un cas réel
Il y a trois semaines, j’ai changé la façon de relancer les clients qui n’avaient pas payé une facture : plus de rappel automatique à 30 jours pile, remplacé par un premier rappel à 15 jours, cordial, puis un second à 30. Sans fichier, cette décision existe seulement dans ma tête et dans une ligne de courriel envoyée à personne d’autre que moi-même. Un mois plus tard, une future session de Claude (ou moi, en train de relire mes propres notes) tombe sur le nouveau modèle de courriel et se pose la question évidente : pourquoi deux rappels plutôt qu’un seul, plus tôt ? Sans decisions.md, la réponse demande de retrouver l’échange où j’avais expliqué le changement, s’il existe encore.
Avec le fichier, l’entrée du jour dit :
## 2026-08-02 — Passage à deux rappels de facture plutôt qu'un
Le rappel unique à 30 jours arrivait trop tard : les clients avaient
souvent déjà oublié la facture et réglaient avec un mois de retard.
Un premier rappel cordial à 15 jours, avant que le dossier ne
refroidisse, a fait tomber le délai de paiement moyen de 34 à 19 jours.
Une session ouverte le mois suivant, avec @decisions.md chargé, répond directement à la question sans que personne n’ait besoin de fouiller. C’est toute la valeur du fichier : il transforme un choix qui vivait uniquement dans une tête (ou dans un échange qu’on ne retrouve plus) en une ligne que Claude peut citer telle quelle.
Étape 5 — La discipline qui fait tenir le système (2 minutes)
Un fichier vide ne sert à rien, et un fichier qu’on remplit trois mois après coup ment autant qu’il informe. La règle qui marche en pratique : tu écris une ligne au moment où tu prends la décision, pas en fin de journée en essayant de te souvenir. Deux minutes, sur le moment, valent mieux qu’une reconstitution approximative le lendemain.
Un signal fiable pour savoir quand écrire : si tu viens de justifier un choix à voix haute ou par écrit à quelqu’un (un collègue, un ticket, un commit), c’est que ce choix mérite une ligne dans decisions.md. Tu as déjà fait le travail de formulation, il ne reste qu’à le copier.
Cette discipline reste la tienne, mais tu peux demander à Claude de t’y aider. Ajoute deux lignes au CLAUDE.md :
Quand on prend une décision structurante, propose une ligne pour `decisions.md`.
Note dans `journal.md` ce qui a été fait et ce qui reste à faire en fin de tâche.
Ce ne sont plus des imports (@fichier.md, qui chargent du contenu), mais des instructions de comportement : elles disent à Claude quoi faire, pas quoi lire. En session, Claude va alors proposer une ligne au moment où une décision se prend, au lieu que tu doives t’en souvenir seul.
Attention à ne pas confondre aide et automatisation totale. Deux garde-fous à garder :
- Le mot « propose » compte. Demande à Claude de proposer une ligne, jamais de l’écrire seul sans validation. C’est toi qui juges si le choix est structurant, Claude ne le sait pas mieux que toi, il note souvent trop.
journal.mdpollue vite si tu lui laisses l’autonomie complète. Sans garde-fou, Claude y consigne chaque petite action (un fichier renommé, un test relancé) et le fichier devient aussi illisible qu’un fichier jamais tenu. La discipline manuelle décrite plus haut, écrire toi-même au moment de la décision, reste le réflexe premier ; la ligne CLAUDE.md n’est qu’un filet pour les fois où tu oublies, pas un substitut.
La limite qui arrive, et à quel moment
Cette arborescence tient très bien jusqu’à un certain volume, puis elle craque d’un coup. Le signe : ton decisions.md dépasse les deux ou trois cents lignes, et tu passes plus de temps à faire défiler le fichier pour retrouver une entrée qu’à la lire. À ce stade, deux options, pas plus : découper par trimestre (decisions-2026-T3.md, decisions-2026-T4.md, avec un seul importé à la fois dans le CLAUDE.md), ou basculer vers une mémoire cherchable comme claude-mem, qui range chaque note dans un classement consultable (un index) et va y chercher seulement ce qui compte, au lieu de tout recharger d’un bloc à chaque session. Il n’y a pas de mauvais choix ici : le fichier texte reste la bonne solution pour un projet actif de quelques mois, l’outil devient rentable à partir du moment où l’historique dépasse ce qu’une lecture rapide peut couvrir.
L’autre limite, moins visible : @import charge tout le contenu à chaque session, que tu en aies besoin ou non. Cent lignes de décisions, c’est un coût de contexte négligeable. Mille lignes, c’est déjà un fichier que Claude relit en entier avant même que tu poses une question, contrairement à la recherche par index vue avec mem-search, qui ne charge que ce qui est pertinent.
Le test qui prouve que ça marche
Ferme la session, rouvre-en une nouvelle, et demande directement : « pourquoi on a abandonné la librairie de dates ? » sans rien préciser d’autre. Si Claude répond avec le contenu exact de ton entrée du 15 août, sans que tu aies eu besoin de rouvrir le fichier toi-même, le système fonctionne. Si la réponse est vague ou inventée, vérifie d’abord que la ligne @decisions.md est bien dans le CLAUDE.md, puis que /context confirme le chargement.
En résumé
- Deux fichiers suffisent :
decisions.mdpour le pourquoi,journal.mdpour le fait accompli. Ne les mélange pas. - Chaque entrée de
decisions.mda une date, un titre, et un pourquoi en une ou deux phrases : sans le pourquoi, l’entrée ne sert à rien. @decisions.mddans leCLAUDE.mdde projet suffit à charger le fichier à chaque session, même mécanisme que l’imbrication deCLAUDE.md.- Écris la ligne au moment de la décision, pas en reconstitution différée. Une instruction dans le
CLAUDE.md(« propose une ligne ») peut t’y aider, mais reste un filet, pas un remplacement : laissée en autonomie complète, l’IA pollue vitejournal.md. - Cette approche tient jusqu’à deux ou trois cents lignes ; au-delà, découpe par trimestre ou passe à une mémoire cherchable comme
claude-mem.
Prochaine étape : sortir du fichier texte plat pour un vrai vault de connaissances, avec Obsidian.
Cette mise en pratique poursuit la série sur l’installation et la configuration de Claude Code, de zéro jusqu’à un premier programme fonctionnel. La vidéo est ici.
Abonne-toi au blog pour suivre la suite de la série.